 Von Cyber-Resilienz über Flash-basierte Speichererweiterungen bis zur integrierten Datenplattform: Die besuchten Unternehmen während der IT Press Tour zeigten allesamt, an welchen Stellen Unternehmen ihre Infrastruktur für den produktiven, effizienten Einsatz künstlicher Intelligenz (KI) weiterentwickeln.
Künstliche Intelligenz verändert die Anforderungen an Enterprise-IT. Leistungsfähige GPUs allein reichen nicht aus, um große Modelle effizient zu trainieren und zuverlässig zu betreiben. Ebenso entscheidend sind ein schneller und kontrollierter Datenzugriff, leistungsfähige Speicherarchitekturen, ausfallsichere Workloads und eine Infrastruktur, die sich ohne unnötige Komplexität verwalten lässt.
Bei der IT Press Tour präsentierten Cohesity, Ctera, Phison, Clockwork.io, Scaleflux, DDN, VergeIO und Hammerspace ihre Ansätze für diese Herausforderungen. Während einige Unternehmen ihre bestehenden Plattformen um Funktionen für KI erweitern, konzentrieren sich andere auf spezialisierte Speicherkomponenten, die Ausfallsicherheit verteilter Rechenprozesse oder die Integration unterschiedlicher Infrastrukturkomponenten.
Die aktuellen Entwicklungen verdeutlichen, dass sich die Optimierung von KI-Systemen über die gesamte Datenpipeline erstreckt – von der sicheren Bereitstellung der Unternehmensdaten über deren Verarbeitung bis hin zur Wiederherstellung und produktiven Nutzung der Ergebnisse.
Cohesity: Cyber-Resilienz und Datensicherheit für das KI-Zeitalter
Cohesity konzentriert sich auf Datensicherung, Cyber-Resilienz und die sichere Nutzung von Unternehmensdaten. Die Cohesity-Data-Cloud verbindet Funktionen für den Schutz und die Wiederherstellung von Daten mit Sicherheitsanalysen und der Bereitstellung von Informationen für KI-Anwendungen. Dabei geht es nicht mehr allein darum, Backups anzulegen. Unternehmen müssen auch sicherstellen, dass Daten nach einem Angriff zuverlässig wiederhergestellt werden können und sich sensible Informationen kontrolliert für neue Anwendungen nutzen lassen.
Statement from Vasu Murthy, Senior VP and CPO Cohesity
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Ein aktueller Schwerpunkt ist der Einsatz leistungsfähiger KI-Modelle zur Erkennung von Schwachstellen in der eigenen Software. Auf der IT Press Tour erläuterte Cohesity, dass das Unternehmen Anthropics-Modell Mythos im Rahmen von Project Glasswing zur Sicherheitsanalyse seines Quellcodes nutzt. Parallel untersucht Cohesity Modelle von OpenAI und Google sowie Open-Weight-Modelle und Ansätze in Zusammenarbeit mit Nvidia. Nach bisherigen Testergebnissen bewertet das Unternehmen Mythos bei der Suche nach Schwachstellen als leistungsfähiger als GPT-5.6 Cyber. Diese Einschätzung bezieht sich ausdrücklich auf die untersuchten Modelle für offensive Sicherheitsanalysen.
Darüber hinaus erweitert Cohesity seinen Ansatz für Cyber-Resilienz. Das Unternehmen strukturiert die Schutzmaßnahmen in fünf Schritte: Workloads absichern, Backups isoliert speichern, Bedrohungen erkennen, Anwendungen wiederherstellen und die Wirksamkeit der Schutzmaßnahmen regelmäßig überprüfen. Unveränderliche Backups, Bedrohungsanalysen und Wiederherstellungstests in isolierten Clean-Rooms sollen sicherstellen, dass Systeme nach einem Angriff nicht nur technisch verfügbar sind, sondern auch wieder funktionsfähig arbeiten.
Ein weiteres Entwicklungsfeld ist die Absicherung autonomer KI-Agenten. Deren Prompts, Speicherzustände, Vektordatenbanken und Verbindungen zu anderen Systemen müssen ebenso geschützt und wiederherstellbar sein wie klassische Anwendungsdaten. Cohesity arbeitet deshalb an Funktionen, um solche Agenten zu erkennen, zu sichern und ihren Zustand bei Bedarf wiederherzustellen.
Gleichzeitig sollen vorhandene Backup-Daten als Grundlage für KI-Anwendungen dienen. Ein Katalog und eine semantische Ebene sollen Informationen verfügbar machen, ohne dafür zwingend zusätzliche Datenkopien erstellen zu müssen. Damit verbindet Cohesity die Absicherung bestehender Datenbestände mit deren kontrollierter Nutzung für neue KI-Workloads.
Info: Link zum vollständigen Artikel auf Netzpalaver: Cohesity verbindet Cyber-Resilienz mit KI-gestützter Datensicherheit
Ctera: Unstrukturierte Unternehmensdaten für KI nutzbar machen
Ctera entwickelt eine Intelligent-Data-Platform für das Management unstrukturierter Daten. Die softwaredefinierte Plattform führt verteilte Dateibestände aus Edge-Standorten, Rechenzentren und Cloud-Umgebungen in einer gemeinsamen Dateninfrastruktur zusammen. Ziel ist es, verteilte Speicherressourcen zentral zu verwalten, den Zugriff auf Dateien zu kontrollieren und vorhandene Unternehmensdaten für KI-Anwendungen zugänglich zu machen.
Statement from Oded Nagel, CEO CTERA
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Auf der IT Press Tour stand weniger eine neue Speicherkomponente als vielmehr die Frage im Mittelpunkt, wie sich KI-Projekte in produktive Geschäftsprozesse überführen lassen. Mit dem neuen Service Forward-Deployed-Engineering will Ctera Unternehmen dabei unterstützen, konkrete Anwendungsfälle auf Basis ihrer vorhandenen Daten umzusetzen.
Dazu arbeiten Ctera-Ingenieure direkt in den Projektteams der Kunden. Sie analysieren die vorhandenen Datenbestände, berücksichtigen Zugriffsrechte und Governance-Vorgaben und entwickeln daraus produktive KI-Workflows. Die Zusammenarbeit soll sich an einem definierten Geschäftsergebnis orientieren, statt lediglich eine technische Implementierung bereitzustellen.
Ein wichtiger Aspekt ist die Qualität der Datenbasis. Über Jahre gewachsene Dateiablagen enthalten häufig redundante, veraltete oder falsch klassifizierte Informationen. Ebenso können historisch gewachsene Berechtigungen zu Risiken führen, wenn KI-Anwendungen auf Inhalte zugreifen, die für bestimmte Nutzer nicht vorgesehen sind. Ctera setzt deshalb darauf, die bestehenden Berechtigungen bei der Nutzung der Daten durch KI-Workflows zu berücksichtigen.
Für die Integration in vorhandene Systeme und Automatisierungsumgebungen kommen unter anderem offene Standards wie das Model-Context-Protocol (MCP) sowie Plattformen wie n8n zum Einsatz.
Das Servicemodell sieht außerdem eine Übergabe an die Kunden vor. Mitarbeiter arbeiten bereits während der Implementierung mit den Ctera-Ingenieuren zusammen. Nach Abschluss des Projekts sollen sie den entwickelten Workflow selbstständig betreiben und auf weitere Anwendungsfälle übertragen können.
Ctera adressiert damit zwei zusammenhängende Herausforderungen: den kontrollierten Zugriff auf verteilte Unternehmensdaten und den Mangel an spezialisiertem Engineering-Wissen für die praktische Umsetzung von KI-Projekten.
Info: Link zum vollständigen Artikel auf Netzpalaver: Ctera setzt auf Forward-Deployed-Engineering gegen den KI-Fachkräftemangel
Phison: Flash-Speicher erweitert den verfügbaren KI-Arbeitsspeicher
Phison ist auf NAND-Flash-Controller, SSD-Technologien und kundenspezifische Speicherlösungen spezialisiert. Das Unternehmen entwickelt sowohl eigene Speicherkomponenten als auch Technologien für Partner, die darauf aufbauend individuelle Speichersysteme realisieren. Mit seiner Adaptive-Technologie überträgt Phison diesen Ansatz auf eine zentrale Herausforderung lokaler KI-Anwendungen: den begrenzten Speicherplatz für große Modelle.
KI-Systeme halten Modellgewichte, Zwischenergebnisse und weitere Daten üblicherweise im GPU-Speicher und im DRAM vor. Sind diese Ressourcen erschöpft, lassen sich größere Modelle oder umfangreichere Aufgaben nicht ohne Weiteres ausführen. Phison ergänzt die bestehende Speicherhierarchie deshalb um eine zusätzliche Flash-basierte Ebene, die als Adaptive-Cache-Memory bezeichnet wird.
Die Lösung kombiniert eine speziell ausgelegte SSD im M.2- oder U.2-Format mit einer Software-Schicht. Die Adaptive-Middleware verschiebt Daten abhängig vom Bedarf zwischen GPU-Speicher, DRAM und Flash. Dadurch sollen sich größere Modelle betreiben lassen, ohne zusätzliche GPUs oder mehr DRAM installieren zu müssen.
Eine wesentliche Weiterentwicklung betrifft Mixture-of-Experts-Modelle (MoE). Obwohl bei diesen Modellen für eine einzelne Verarbeitung nur ein Teil der Experten aktiviert wird, müssen die zugehörigen Modellgewichte verfügbar bleiben. Adaptive kann Teile dieser Gewichte auf den Flash-Speicher auslagern und bei Bedarf nachladen. Nach Angaben von Phison lässt sich dadurch bis zu etwa die Hälfte des Modells auf die zusätzliche Speicherebene verschieben.
In einer Demonstration wurde ein Modell mit einem regulären Speicherbedarf von rund 24 GByte auf einem System mit 16 GByte Arbeitsspeicher ausgeführt. Phison weist darauf hin, dass Flash langsamer als DRAM ist. Die Technologie soll daher nicht jede Speicheranforderung mit gleicher Geschwindigkeit bedienen, sondern Anwendungen ermöglichen, die andernfalls an der verfügbaren Speicherkapazität scheitern würden.
Ein weiterer Anwendungsfall ist der Key-Value-Cache, kurz KV-Cache. Er speichert Zwischenergebnisse der KI-Berechnung und kann bei langen Kontexten erheblich wachsen. Auch hier soll Adaptive Teile der Daten auf Flash auslagern und dynamisch nachladen.
Für den KI-Einsatz passt Phison darüber hinaus Firmware und Schreibverhalten an die besonderen Anforderungen an. Das Unternehmen nennt eine Auslegung von bis zu 100 vollständigen Laufwerks-Schreibvorgängen pro Tag. Zusammen mit der Middleware soll dies die Speicherbelastung bei schreibintensiven Workloads kontrollieren.
Der Ansatz erweitert die Möglichkeiten lokaler KI-Systeme, bringt jedoch einen klaren Kompromiss mit sich: Mehr nutzbarer Speicher wird durch zusätzliche Datenbewegungen und höhere Zugriffszeiten gegenüber DRAM erkauft.
Info: Link zum vollständigen Artikel auf Netzpalaver: Arbeitsspeicher für lokale KI-Anwendungen per Flash optimiert
Clockwork.io: KI-Workloads trotz Infrastrukturfehlern weiterführen
Clockwork.io konzentriert sich auf die Ausfallsicherheit großer KI-Infrastrukturen. Die Technologie des Unternehmens setzt zwischen der Hardware und den eigentlichen KI-Workloads an. Sie soll verhindern, dass der Ausfall einer GPU, eines Netzwerkpfads oder anderer Infrastrukturkomponenten einen aufwendigen Trainingslauf vollständig unterbricht.
Statement from Suresh Vasudevan, CEO, Clockwork
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Clockworks Ansatz ist eine Art softwarebasierte Fehlerbehandlung für KI-Workloads, bei der Netzwerkfehler und Hardwareausfälle während der Verarbeitung abgefangen werden sollen. Zwei Komponenten übernehmen dabei unterschiedliche Aufgaben. Linkpass kann den Netzwerkverkehr bei einem ausgefallenen Verbindungsweg auf einen funktionierenden Pfad umleiten. Torchpass ermöglicht es, laufende Workloads von einer fehlerhaften GPU auf eine verfügbare GPU zu verschieben. Dadurch soll ein Training fortgesetzt werden können, ohne zunächst einen älteren Checkpoint laden und den gesamten betroffenen Rechenabschnitt wiederholen zu müssen.
Der Ansatz gewinnt mit der Größe von KI-Clustern an Bedeutung. Je mehr GPUs und Netzwerkverbindungen beteiligt sind, desto größer wird das Risiko, dass einzelne Komponenten während eines langen Trainingslaufs ausfallen. Müssen solche Fehler durch einen vollständigen Neustart des Jobs abgefangen werden, gehen bereits geleistete Berechnungen verloren.
Anfang Oktober 2026 meldete Clockwork.io eine Finanzierungsrunde über 31 Millionen US-Dollar. Das Kapital soll die Weiterentwicklung und Verbreitung der Fault-Tolerance-Technologien unterstützen. Die Gesamtfinanzierung des Unternehmens steigt damit nach eigenen Angaben auf 73 Millionen US-Dollar.
Zugleich berichtete Clockwork.io über produktive Einsätze seiner Software bei LinkedIn und Together-AI sowie eine ausgeweitete Nutzung bei Whitefiber. Die strategische Ausrichtung liegt darin, Fehler möglichst innerhalb des laufenden Betriebs zu behandeln, statt sie erst durch einen Neustart des gesamten KI-Jobs zu beheben.
Damit rückt neben der maximalen Rechenleistung auch deren tatsächliche Verfügbarkeit in den Mittelpunkt. Für Betreiber großer GPU-Cluster ist entscheidend, wie viel der installierten Rechenkapazität trotz unvermeidbarer Hardware- und Netzwerkfehler produktiv genutzt werden kann.
Info: Link zum vollständigen Artikel auf Netzpalaver: Clockwork.io erhält 31 Millionen US-Dollar für ausfallsichere KI-Infrastrukturen
Scaleflux: Neue Controller für eine zunehmend speicherabhängige KI-Infrastruktur
Scaleflux entwickelt NVMe-SSDs, SSD-Controller und CXL-Speicherkomponenten für Rechenzentren und Enterprise-Infrastrukturen. Ein Schwerpunkt liegt auf Computational-Storage: Bestimmte Verarbeitungsschritte werden näher an den Speicher verlagert, damit Daten nicht für jede Operation vollständig an CPU oder GPU übertragen werden müssen.
Statement from Pichai Balaji VP Products and Marketing, ScaleFlux
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Auf der IT Press Tour stellte Scaleflux zwei neue Controller vor. Der FC6116 ist ein NVMe-SSD-Controller mit PCIe-Gen 6. Das Unternehmen sieht ihn als Baustein für leistungsfähige und individuell ausgelegte Speicherlösungen.
Mit dem MC600 präsentierte Scaleflux außerdem die zweite Generation seines CXL-Memory-Controllers. Er unterstützt CXL 3.2 und soll Funktionen für Zuverlässigkeit, Verfügbarkeit und Wartbarkeit (RAS) bereitstellen.
Hinter den Entwicklungen steht eine Verschiebung der Infrastrukturengpässe. KI-Anwendungen benötigen nicht nur mehr Rechenleistung, sondern auch größere Speicherbereiche und eine möglichst kontinuierliche Versorgung der Beschleuniger mit Daten. Sind die Daten nicht rechtzeitig verfügbar, können GPUs ihre Rechenleistung nicht vollständig ausschöpfen. Scaleflux betrachtet deshalb die Speichercontroller als wichtigen Bestandteil der gesamten Datenpipeline.
Computational-Storage soll dazu beitragen, unnötige Datenbewegungen zu reduzieren. Funktionen wie Kompression oder Filterung lassen sich näher am Speicher ausführen, sofern die jeweilige Anwendung dafür geeignet ist. Das kann Übertragungsaufwand verringern und den Verbrauch von Rechen- und Speicherressourcen beeinflussen.
Parallel verändert Scaleflux sein Geschäftsmodell. Statt ausschließlich komplette SSDs anzubieten, will das Unternehmen seine Controller, Firmware und Entwicklungsleistungen stärker als Grundlage für kundenspezifische Speicherprodukte positionieren. Hersteller und Integrationspartner sollen damit Laufwerke anhand konkreter Anforderungen an Kapazität, Bauform und Einsatzgebiet entwickeln können.
Info: Link zum vollständigen Artikel auf Netzpalaver: KI verschiebt den Engpass in Richtung Speicher
DDN: Eine Datenplattform für KI-Training und Inferenz
DDN entwickelt Dateninfrastrukturen für High-Performance Computing (HPC) und KI. Im Mittelpunkt stehen Speichersysteme, die große Datenmengen mit hohen Durchsatzraten und möglichst geringer Verzögerung bereitstellen müssen. Mit Exascaler und Infinia deckt DDN unterschiedliche Anforderungen innerhalb der KI-Datenpipeline ab.
Statement from Omer Asad, Chief Product Officer at DDN
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Exascaler basiert auf dem parallelen Dateisystem Lustre und richtet sich an datenintensive Trainings- und HPC-Umgebungen. DDN ergänzt die Technologie um Funktionen für den Betrieb großer Installationen, darunter Mandantenfähigkeit und Quality of Service. Damit sollen sich umfangreiche Speicherumgebungen einfacher bereitstellen und verwalten lassen.
Infinia ergänzt das Portfolio um eine skalierbare Datenplattform für Inferenz, Retrieval-Augmented-Generation (RAG), Datenaufbereitung und den schnellen Zugriff auf Informationen während der Modellausführung. Die beiden Technologien sollen innerhalb einer gemeinsamen Plattform zusammenwirken und Daten von der Aufnahme über die Vorbereitung und das Training bis zur produktiven Inferenz verfügbar machen.
Die Anforderungen unterscheiden sich dabei deutlich. Beim Training großer Modelle kommt es auf parallele Datenzugriffe und einen hohen kontinuierlichen Durchsatz an. Bei Inferenz und RAG gewinnen dagegen niedrige Latenzen, effizientes Metadatenmanagement und der schnelle Zugriff auf relevante Informationen an Bedeutung.
DDN verweist auf eine langjährige Zusammenarbeit mit Nvidia. Nach Angaben des Unternehmens nutzt Nvidia die DDN-Speicherinfrastruktur für mehr als 9.000 GPUs und Datenbestände von annähernd 30 Petabyte. Als weiteres Beispiel nennt DDN große KI-Umgebungen bei Mistral, in denen bis zu 100.000 GPUs innerhalb eines Clusters auf die Speicherinfrastruktur zugreifen sollen.
Die entscheidende Aufgabe besteht aus Sicht von DDN darin, die Datenversorgung an die Skalierung der Rechenleistung anzupassen. Schnelleres Training allein genügt nicht, wenn Datenzugriffe und Checkpoints zum Engpass werden oder GPUs auf die nächsten Verarbeitungsschritte warten müssen.
Mit der Kombination aus Exascaler und Infinia richtet DDN seine Plattform deshalb auf den gesamten Lebenszyklus von KI-Anwendungen aus. Die technische Differenzierung liegt in der Verbindung aus leistungsfähigem parallelem Dateizugriff für das Training und einer Datenplattform für Inferenz und datenintensive Anwendungen.
Info: Link zum vollständigen Artikel auf Netzpalaver: DDN kombiniert „ExaScaler“ und „Infinia“ zu einer skalierbaren KI-Datenplattform
VergeIO: Virtualisierung, Storage und Netzwerk in einer Plattform
VergeIO entwickelt mit VergeOS ein Infrastruktur-Betriebssystem, das Virtualisierung, softwaredefinierten Speicher und Netzwerkfunktionen in einer gemeinsamen Plattform zusammenführt. Hinzu kommen Funktionen für Datensicherung und Disaster-Recovery. Das Konzept soll die Zahl separat zu verwaltender Infrastrukturkomponenten reduzieren und Unternehmen eine Alternative zu klassisch getrennten Virtualisierungs- und Speicherarchitekturen bieten.
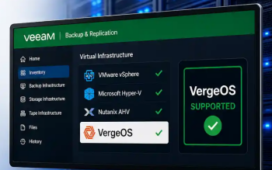
Ein aktueller Schwerpunkt ist die Integration von VergeOS in Veeam-Backup & Replication. Mit der Unterstützung durch Veeam-Backup & Replication 13.1 können Unternehmen virtuelle Workloads auf VergeOS über eine etablierte Backup-Plattform sichern und wiederherstellen.
Die technische Grundlage ist die Universal-Hypervisor-API von Veeam. VergeOS wird darüber direkt als unterstützte Virtualisierungsplattform eingebunden. Die Integration ersetzt einen zuvor von VergeIO genutzten Ansatz über den oVirt-KVM-Treiber. Nach Angaben des Unternehmens sind für die neue Anbindung keine zusätzlichen Treiber oder individuellen Workarounds erforderlich.
Unterstützt werden unter anderem inkrementelle Backups auf Basis von Changed-Block-Tracking, die Wiederherstellung einzelner Dateien und Anwendungen sowie plattformübergreifende Wiederherstellungen. Auch der Export in verschiedene virtuelle Festplattenformate gehört zum Funktionsumfang.
Die Integration ist insbesondere für Unternehmen relevant, die eine Ablösung ihrer bisherigen Virtualisierungsumgebung prüfen. Bestehende Backup- und Recovery-Prozesse müssen bei einem Plattformwechsel nicht grundsätzlich neu aufgebaut werden.
VergeOS und Veeam übernehmen dabei unterschiedliche Aufgaben. VergeOS bietet unter anderem Snapshots virtueller Rechenzentren, standortübergreifende Replikation und Schutzmechanismen auf Infrastrukturebene. Veeam ergänzt dies um granulare Sicherungs- und Wiederherstellungsfunktionen für einzelne Workloads, Dateien und Anwendungen.
Allerdings sind nicht sämtliche Veeam-Funktionen für VergeOS verfügbar. Insbesondere VM-Replikation über Veeam und Continuous-Data-Protection (CDP) werden für diese Plattform in Version 13.1 nicht unterstützt. Für die standortübergreifende Replikation verweist VergeIO auf die eigene Funktion ioReplicate.
Die Neuerung unterstreicht damit einen zentralen Punkt bei der Modernisierung virtualisierter Infrastrukturen: Eine alternative Plattform muss sich nicht nur technisch betreiben lassen, sondern auch in bestehende Datensicherungs- und Wiederherstellungsprozesse integrieren.
Info: Link zum vollständigen Artikel auf Netzpalaver: Virtualisierungsplattform „VergeOS“ wird offiziell von Veeam-Backup & Replication unterstützt
Hammerspace: Einheitlicher Datenzugriff ohne neue Storage-Silos
Hammerspace entwickelt eine Datenplattform, die verteilte Speicherumgebungen über einen gemeinsamen Datenraum zusammenführt. Ziel ist es, Anwendungen unabhängig vom physischen Speicherort auf vorhandene Daten zugreifen zu lassen. Damit richtet sich das Unternehmen an Umgebungen, in denen Daten über lokale Speichersysteme, Rechenzentren, Archive und Cloud-Infrastrukturen verteilt liegen.
Die Plattform abstrahiert das Dateisystem von der darunterliegenden Speicherhardware. Bestehende Speicherressourcen lassen sich dadurch in einen gemeinsamen Namensraum integrieren, ohne sämtliche Daten auf ein neues System kopieren zu müssen. Unterstützt werden unter anderem NFS, SMB, S3 und ein CSI-Treiber für containerisierte Workloads.
Für KI-Anwendungen ist dieser Ansatz relevant, weil die benötigten Daten häufig in unterschiedlichen Systemen und Speicherklassen liegen. Werden Daten für jeden neuen Anwendungsfall manuell kopiert und aufbereitet, entstehen zusätzlicher Speicherbedarf, Verwaltungsaufwand und weitere Datenkopien, die kontrolliert werden müssen.
Hammerspace automatisiert deshalb die Datenplatzierung zwischen unterschiedlichen Speicherstufen. Daten können abhängig von Richtlinien, Workflows und erwarteten Zugriffen im Hintergrund verschoben werden. Beispielsweise lassen sich Daten vor einem Rechenlauf auf schnelleren Speichermedien bereitstellen und Checkpoints nach der Verarbeitung in günstigeren Objektspeicher auslagern.
Ein weiterer Schwerpunkt ist die Einbindung lokaler NVMe-Laufwerke in GPU-Servern. Hammerspace fasst diese häufig isolierten Speicherkapazitäten unter der Bezeichnung Tier-Zero zu einer gemeinsam nutzbaren Leistungsebene zusammen. Unternehmen sollen dadurch vorhandene Ressourcen besser auslasten und den Bedarf an zusätzlichem netzwerkgebundenem Flash-Speicher reduzieren können.
Die Plattform steuert die Datenplatzierung auf Dateiebene. Dadurch müssen nicht zwangsläufig vollständige Volumes migriert werden. Die physikalischen Grenzen der Speichertechnologien bleiben allerdings bestehen: Daten aus Archiven oder Bandspeichern benötigen weiterhin entsprechende Abrufzeiten.
Hammerspace setzt damit auf eine Trennung von Datenzugriff und physischem Speicherort. Statt neue isolierte Speicherbereiche für jede Anwendung einzurichten, sollen vorhandene Datenbestände übergreifend nutzbar werden. Für KI- und HPC-Workloads steht dabei im Vordergrund, Daten rechtzeitig am benötigten Ort bereitzustellen, ohne unnötige Kopierprozesse auszulösen.
Info: Link zum vollständigen Artikel auf Netzpalaver: Einheitlicher Datenzugriff statt neuer Storage-Silos
Fazit: KI-Infrastruktur wird zur Aufgabe der gesamten Datenpipeline
Die acht Unternehmen setzen an unterschiedlichen Stellen derselben Herausforderung an. Cohesity erweitert Datensicherung und Cyber-Resilienz um den Schutz autonomer KI-Agenten und die Nutzung vorhandener Backup-Daten. Ctera konzentriert sich darauf, unstrukturierte Unternehmensdaten kontrolliert für produktive KI-Workflows aufzubereiten. Phison und Scaleflux arbeiten an Speicherarchitekturen, die zusätzliche Kapazität bereitstellen oder unnötige Datenbewegungen reduzieren sollen.
Clockwork.io adressiert den Ausfall einzelner Komponenten in großen KI-Clustern. DDN verbindet leistungsfähiges Storage für das Training mit einer Datenplattform für Inferenz. VergeIO führt zentrale Infrastrukturkomponenten zusammen und erweitert die Integration in bestehende Backup-Prozesse. Hammerspace wiederum setzt auf einen einheitlichen Zugriff auf verteilte Datenbestände, ohne dafür neue Speicherinseln schaffen zu müssen.
Über alle Ansätze hinweg zeigt sich eine gemeinsame Entwicklung: Die Leistungsfähigkeit von KI-Infrastrukturen hängt nicht allein von Prozessoren und Beschleunigern ab. Ebenso wichtig sind die Verfügbarkeit und Qualität der Daten, die Effizienz ihrer Bereitstellung, die Ausfallsicherheit der Verarbeitung und die Integration in vorhandene IT-Strukturen.
Für Unternehmen bedeutet das, KI-Projekte nicht isoliert als Softwarevorhaben zu betrachten. Erst das Zusammenspiel aus Datenmanagement, Speicher, Rechenleistung, Sicherheit und Betrieb schafft die Voraussetzungen, um KI-Anwendungen zuverlässig und wirtschaftlich in den produktiven Einsatz zu überführen.