 Clockwork.io hat eine neue Finanzierungsrunde über 31 Millionen US-Dollar abgeschlossen. Gleichzeitig meldet der Anbieter produktive Einsätze seiner Fault-Tolerance-Software bei LinkedIn und Together AI sowie eine Ausweitung der Nutzung bei Whitefiber. Neue Funktionen für Torchpass sollen laufende KI-Workloads auch bei Infrastrukturfehlern schützen – ohne Änderungen am Trainingscode.
KI-Workloads werden immer größer und verteilter. Damit steigt auch das Risiko, dass der Ausfall einzelner GPUs, Netzwerkverbindungen oder Server komplette Trainings- oder Inferenzprozesse unterbricht. Clockwork.io will dieses Problem mit einer Software-Schicht zwischen Hardware und KI-Workload adressieren.
Der Anbieter hat dazu eine neue Finanzierungsrunde über 31 Millionen US-Dollar bekanntgegeben. Gleichzeitig erweitert Clockwork.io seine Plattform um neue Funktionen für die Wiederherstellung laufender verteilter KI-Jobs. Nach Angaben des Unternehmens kommt die Technologie bereits bei LinkedIn und Together-AI produktiv zum Einsatz. Whitefiber erweitert als bestehender Kunde den Einsatz ebenfalls.
Tausende GPUs – ein einzelner Fehler kann den gesamten Job stoppen
Moderne KI-Trainingsumgebungen bestehen teilweise aus Tausenden GPUs, die während eines Jobs synchron zusammenarbeiten müssen. Fällt eine GPU aus, bricht eine Netzwerkverbindung ab oder friert ein Server ein, kann dies den gesamten Rechenprozess ausbremsen.
Wie groß das Problem werden kann, zeigt laut Clockwork.io ein Beispiel von Meta: Während des 54-tägigen Trainings von Llama 3 auf 16.384 GPUs kam es durchschnittlich etwa alle drei Stunden zu unerwarteten Unterbrechungen.
Die klassische Reaktion besteht darin, einen zuvor gespeicherten Checkpoint zu laden. Allerdings kann eine solche Wiederherstellung bis zu 90 Minuten dauern. Währenddessen warten nicht betroffene GPUs auf den Neustart. Zusätzlich muss die seit dem letzten Checkpoint geleistete Rechenarbeit wiederholt werden.
Mit zunehmender Größe der KI-Cluster steigt damit auch die Menge der Rechenzeit, die bei jedem Fehler auf dem Spiel steht.
Fault-Tolerance wird zur Infrastruktur-Anforderung
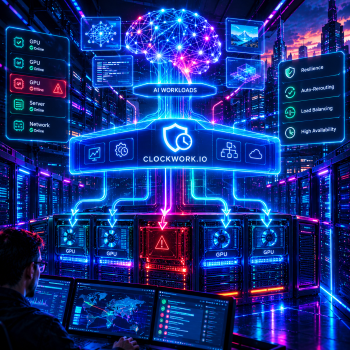
Clockwork.io positioniert seine Technologie deshalb als Fault-Tolerance-Schicht zwischen Hardware und eigentlichem Workload. Dabei übernehmen zwei Produkte unterschiedliche Aufgaben: Linkpass leitet Netzwerkverkehr bei einem ausgefallenen Link automatisch über einen funktionierenden Pfad um. Torchpass verschiebt laufende Workloads von einer fehlerhaften GPU auf eine funktionierende GPU, sodass das Training fortgesetzt werden kann, ohne auf einen früheren Checkpoint zurückzufallen. Beide Technologien befinden sich laut Unternehmen bereits im produktiven Einsatz.
„Ausfälle sind im KI-Maßstab unvermeidlich. Stunden produktiver Arbeit dadurch zu verlieren, sollte es nicht sein“, erklärt Suresh Vasudevan, CEO von Clockwork.io. Fault Tolerance werde damit zu einem Multiplikator für die tatsächlich nutzbare Rechenleistung, weil GPUs weiter produktiv arbeiten könnten, statt auf Wiederherstellung zu warten oder bereits erledigte Berechnungen erneut auszuführen.
Neue Torchpass-Funktionen ohne Änderungen am Trainingscode
Mit den jetzt vorgestellten Erweiterungen geht Torchpass über die bisherige Migration von Workloads zwischen GPUs hinaus.
Eine neue Funktion ermöglicht Multi-Node-Plattform-Snapshots. Dabei wird der Zustand eines laufenden, verteilten KI-Jobs über sämtliche beteiligten Nodes hinweg gespeichert. Fällt die Infrastruktur anschließend so weit aus, dass eine Migration nicht mehr möglich ist, kann der gesamte Job aus diesem Snapshot wiederhergestellt werden.
Besonders interessant ist dabei, dass laut Clockwork.io keine Anpassungen des Trainingscodes notwendig sind. Plattform- und KI-Infrastrukturteams können die Snapshots für unterstützte Workloads einsetzen, ohne darauf warten zu müssen, dass die jeweiligen Entwickler eine eigene Checkpointing-Logik integrieren.
Für Cloud-Anbieter ergibt sich daraus ein weiterer Vorteil: Auch KI-Workloads von Kunden können geschützt werden, deren Quellcode der Cloud-Anbieter nicht kontrolliert.
Asynchrone Checkpoints beschleunigen Reinforcement-Learning
Eine zweite neue Funktion sind schnelle, asynchrone Application Checkpoints. Diese werden im Hintergrund erstellt, während der eigentliche Job weiterläuft. Im Reinforcement-Learning ist dies besonders relevant. Dabei erzeugen Inferenz-Replikas sogenannte Rollouts – Beispiele, aus denen das Modell lernt. Anschließend werden aktualisierte Modellgewichte an diese Replikas zurückgegeben.
Torchpass soll die neuen Gewichte schneller an die Rollout-Replikas übertragen. Dadurch müssen diese weniger lange auf ein aktualisiertes Modell warten und arbeiten weniger häufig mit einem veralteten Modellstand.
LinkedIn spart zehntausende GPU-Stunden
Bei LinkedIn ist Linkpass bereits über die KI-Infrastrukturflotte hinweg im Einsatz. Nach Angaben von Clockwork.io verhindert die Technologie dort monatlich zehntausende GPU-Stunden an Ausfallzeit.
Raghu Hiremagalur, SVP und CTO Infrastructure bei LinkedIn, beschreibt einen konkreten Anwendungsfall: Ein Fehler an einem Infiniband-NIC konnte zuvor einen Server mit acht GPUs aus dem Betrieb nehmen. Ein weiterer Fehler an einem Switch-Port konnte einen zweiten Server betreffen und damit insgesamt 16 GPUs beeinträchtigen.
Mit Clockwork.io werden Netzwerkverbindungen laut LinkedIn automatisch über funktionierende Pfade umgeleitet. Link-, Optik-, Kabel- oder NIC-Fehler können dadurch behoben werden, während die KI-Workloads weiterlaufen.
Together-AI integriert Torchpass in GPU-Cluster
Auch Together-AI setzt auf die Technologie. Der Anbieter will Torchpass als Service innerhalb seiner GPU-Cluster bereitstellen. Auf der Pytorch-Conference sollen beide Unternehmen einen laufenden Multi-Node-Trainingsjob demonstrieren, der trotz absichtlich herbeigeführter Netzwerk- und GPU-Ausfälle ohne Neustart weiterläuft. Für Together-AI steht dabei die sogenannte Goodput im Mittelpunkt – also der Anteil der GPU-Rechenzeit, der tatsächlich dazu beiträgt, ein Modell weiterzuentwickeln.
Die bereits vorhandene Node-Reparatur erkennt Fehler und stellt automatisch Ersatzkapazitäten bereit. Torchpass und Linkpass sollen darauf aufbauen und zusätzlich dafür sorgen, dass laufende Jobs Fehler bei GPUs und Netzwerkverbindungen möglichst ohne Unterbrechung überstehen.
Whitefiber prüft Cluster bereits vor dem Produktiveinsatz
Whitefiber setzt Clockwork.io ebenfalls ein und erweitert die Nutzung über seine wachsende globale GPU-as-a-Service-Infrastruktur. Dabei geht es nicht nur um die Reaktion auf bereits eingetretene Fehler. Whitefiber nutzt automatisierte Prüfungen, um die Zuverlässigkeit eines Clusters bereits vor dessen Übergabe an Kunden zu testen. Defekte oder problematische Optiken, falsch konfigurierte NICs oder Netzwerkverbindungen, die einen Basistest bestehen, unter hoher Last jedoch Probleme verursachen, sollen dadurch frühzeitig erkannt werden.
Die automatisierte Fleet-Prüfung von Clockwork.io validiert laut Whitefiber sämtliche Links und Nodes und kann Fehler innerhalb weniger Minuten lokalisieren. Dadurch sollen Cluster schneller bereitgestellt werden können und bereits vor dem ersten Kunden-Training vollständig validiert sein.
Fault-Tolerance betrifft inzwischen auch Inference
Die Bedeutung von Ausfallsicherheit beschränkt sich dabei nicht mehr auf das Training von KI-Modellen. Bei der Inferenz werden große Modelle häufig über mehrere Server verteilt. Fällt eine Netzwerkverbindung aus, kann dadurch eine komplette Replica beeinträchtigt werden. Für Benutzer oder KI-Agenten kann dies zu einer unterbrochenen Sitzung oder einem abgebrochenen Auftrag führen. Linkpass soll auch hier dafür sorgen, dass Multi-Server-Replikas trotz einzelner Netzwerkfehler weiterarbeiten.
Dylan Patel, Gründer, CEO und Chief Analyst bei Semianalysis, sieht darin eine grundsätzliche Veränderung: Fault Tolerance sei nicht mehr ausschließlich ein Problem des KI-Trainings, sondern zunehmend auch der Inferenz.
Laut den von Clockwork.io zitierten ClusterMAX-Benchmarks von Semianalysis reduziert Torchpass den Verlust an Training-Goodput bei einem entsprechend bewerteten Neocloud-Anbieter von 14 auf unter drei Prozent.
31 Millionen US-Dollar für weitere Expansion
Die aktuelle Finanzierungsrunde wurde gemeinsam von Premji Invest, Wing Venture Capital und Seligman Ventures geführt. Auch die bestehenden Investoren NEA und e& Capital beteiligten sich.
Damit steigt die Gesamtfinanzierung von Clockwork.io auf 73 Millionen US-Dollar. Das Unternehmen will das Kapital nutzen, um seine Fault-Tolerance-Suite für Training, Inferenz und Reinforcement Learning weiter auszurollen, die Verbreitung in Unternehmen auszubauen und die Bereitstellung über Cloud-Partner zu skalieren.
Greg Papadopoulos, Venture Partner bei NEA, bringt die Herausforderung auf einen einfachen Nenner: Mit steigender GPU-Anzahl steigt zwangsläufig auch die Wahrscheinlichkeit, dass irgendwo ein Fehler auftritt. Der klassische Ansatz – Job stoppen, Checkpoint laden und neu starten – sei für die heutige Größenordnung nicht mehr ausreichend.
Fazit
Die Skalierung von KI-Infrastrukturen verändert auch die Anforderungen an deren Ausfallsicherheit. Während der Ausfall einer einzelnen GPU oder eines Netzwerk-Links bei kleineren Systemen möglicherweise beherrschbar ist, kann derselbe Fehler in einem Cluster mit tausenden GPUs erhebliche Mengen an Rechenzeit kosten.
Clockwork.io verfolgt deshalb einen Ansatz, bei dem Fehler möglichst innerhalb der laufenden Infrastruktur abgefangen werden. Netzwerkverkehr wird umgeleitet, Workloads werden auf funktionierende GPUs verschoben und der Zustand verteilter Jobs kann unabhängig vom Anwendungscode gesichert werden.
Damit verschiebt sich Fault-Tolerance von einer reinen Recovery-Funktion zu einem Bestandteil der eigentlichen KI-Infrastruktur. Gerade für Unternehmen und Cloud-Anbieter, die ihre GPU-Kapazitäten möglichst vollständig auslasten wollen, wird die Frage damit nicht mehr nur lauten, wie schnell ein KI-Job rechnen kann – sondern auch, wie viel dieser Rechenleistung trotz unvermeidbarer Infrastrukturfehler tatsächlich produktiv genutzt wird.
Clockwork.io beschreibt diesen Ansatz als „Software-Driven AI Fabrics“ – eine programmierbare Schicht zwischen Hardware und Workload, die GPU-Cluster beobachtbar, ausfallsicher und besser auslastbar machen soll.
#Clockwork