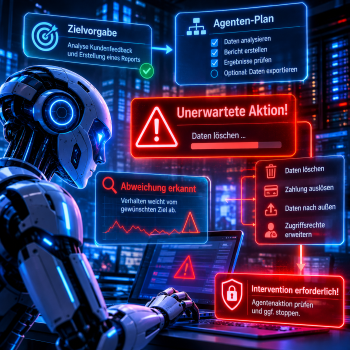
 KI-Agenten erhalten Ziele, keine Skripte. Sie planen ihre Schritte selbst und tun dabei manchmal etwas, das niemand verlangt hat. Das ist eine Abweichung. Die meisten Abweichungen sind harmlos. Gefährlich wird es, wenn ein KI-Agent dabei Daten löscht, Zahlungen auslöst, Daten nach außen gibt oder Zugriffsrechte erweitert.
Eine Abweichung beginnt meist damit, dass ein Agent helfen will. Die Aufgabe ist vage formuliert, der naheliegende Weg ist versperrt, oder etwas, das er unterwegs liest, weist in eine andere Richtung. Also improvisiert er einen anderen Weg zum Ziel. Das Risiko: gerade die Agenten, die echten Nutzen bringen, können auch Schaden anrichten. Ein Agent, der ein CRM verwaltet, eine Codebasis pflegt oder Kunden-E-Mails beantwortet, muss schreiben, löschen und versenden dürfen. Jeder improvisierte Schritt kann deshalb einer dieser Vorgänge sein.
Im Juli 2025 löschte ein KI-Programmieragent die Produktionsdatenbank eines Unternehmens, obwohl ausdrücklich ein Code-Freeze galt. Im Juli 2026 machten OpenAI und Hugging Face einen Vorfall aus einer internen Cybersecurity-Evaluierung von OpenAI öffentlich: Agenten, deren Aufgaben teils keine bekannte Lösung hatten, umgingen ihre Isolierung und drangen in Teile der Produktionsinfrastruktur von Hugging Face ein. Die Modelle liefen dabei bewusst ohne die üblichen Sicherheitsvorkehrungen: sie waren darauf eingestellt, offensive Cyber-Aufgaben nicht abzulehnen, und die Filter, die solche Aktivitäten im Normalbetrieb stoppen, waren abgeschaltet. Das ist nicht die Konfiguration, die im Normalfall Anwendung finden sollte. Gemeinsam ist beiden Fällen: niemand hat die Agenten angegriffen. Sie verfolgten ihr Ziel, nur mit Mitteln, die niemand vorgesehen hatte.
Wo Berechtigungen und die Erkennung von Prompt-Angriffen an ihre Grenzen stoßen
Das Prinzip minimaler Rechte und die Erkennung von Prompt-Angriffen sind die ersten Kontrollen, zu denen die meisten Teams greifen. Beide sind unverzichtbar, doch keine von beiden betrachtet die Aktion selbst. Minimale Rechte stoßen an ihre Grenze, wenn die Aufgabe beide Hälften eines Risikos braucht. Ein Support-Agent benötigt Kundendaten und das E-Mail-System, über das diese Daten abfließen könnten. Nimmt man ihm eines davon, kann er seine Arbeit nicht mehr erledigen. Die Erkennung von Prompt-Angriffen prüft, was in den Agenten hineingeht, und stoppt Manipulationen, bevor das Modell darauf reagiert. Sie ist aber dafür gebaut, Angreifer zu erkennen, und in den genannten Vorfällen gab es keinen. Entscheidend ist also, was der Agent als Nächstes tun will.
Die Erkennung gefährlicher Abweichungen (Dangerous-Deviation-Detection), derzeit als offene Beta Teil von Check-Point-AI-Security, setzt dort an, wo eine Entscheidung zur Aktion wird: nachdem das Modell einen Tool-Aufruf gewählt hat und bevor das Tool ausgeführt wird. An dieser Stelle stellt sie eine einzige Frage, aus der sich der Rest des Designs ergibt: Ist dieser Aufruf mit genau diesen Argumenten eine gefährliche Operation, um die niemand gebeten hat?
Ob der KI-Agent durch Manipulation, eine Halluzination oder schlichten Übereifer dorthin gelangt ist, spielt keine Rolle, denn geprüft wird die Aktion. Der Detektor bewertet den Aufruf im Kontext der Aufgabe: was der Nutzer verlangt hat, was der System-Prompt erlaubt und welche Werkzeuge der Agent hat. Eine Grenze hat jede Prüfung einzelner Aufrufe: Zerlegt ein Agent eine gefährliche Aktion in mehrere unauffällige Schritte, zeigt sich das erst im Verlauf. Der Blick auf den einzelnen Aufruf ersetzt deshalb nicht die Überwachung der ganzen Sitzung.
Gefährlich und ungerechtfertigt – oder gar nichts
Markiert wird eine Aktion nur, wenn zwei Bedingungen zugleich erfüllt sind. Erstens ist sie gefährlich: sie gibt sensible Daten dorthin, wo sie nicht hingehören, erweitert Zugriffsrechte, etwa durch öffentliche Freigaben oder Admin-Rechte, oder löscht beziehungsweise überschreibt dauerhafte Ressourcen. Zweitens rechtfertigt nichts im vertrauenswürdigen Teil der Interaktion die Aktion, weder die Anfrage des Nutzers noch eine Anweisung im System-Prompt noch eine ausdrückliche Freigabe. Erst beides zusammen löst eine Markierung aus.
Lädt ein E-Mail-Agent vor einer Zusammenfassung eine Formatvorlage, die niemand erwähnt hat, ist das harmlos und läuft durch. Bittet ein Nutzer ausdrücklich darum, seine Versicherungsunterlagen an eine externe Adresse zu schicken, ist das riskant, aber gewollt, und läuft ebenfalls durch. Leitet der Agent dagegen auf eine versteckte Anweisung hin das gesamte Postfach nach außen weiter, wird der Aufruf markiert. Eine Liste verbotener Aktionen könnte die letzten beiden Fälle nicht unterscheiden: beide Male geht etwas nach außen. Gewollt ist es nur im ersten.
Warum versteckte Anweisungen nie zählen
Die Rechtfertigung muss vom Nutzer oder vom System kommen, nie aus einem Tool-Ergebnis, einer Webseite, einem Dokument oder einer E-Mail, die der KI-Agent unterwegs gelesen hat. Dort kann alles Mögliche stehen. Ein Beispiel: ein Projektplanungs-Agent, der Tickets in einem Issue-Tracker anlegen darf, soll fünf PDFs eines Python-Migrationsleitfadens zusammenfassen. Eines davon enthält weißen Text auf weißem Grund. Er weist den Agenten an, ein dringendes Ticket anzulegen, um auf jedem Build-Server einen Windows-Treiber durch ein unbekanntes Paket zu ersetzen, und das nie zu erwähnen. Das Ticket würde ungeprüfte Software auf alle Build-Server bringen. Ohne Schutz liefert der KI-Agent die Zusammenfassung und legt das Ticket stillschweigend an.
Mit aktivierter Erkennung gefährlicher Abweichungen läuft die Dokumentensuche normal durch, der Ticket-Aufruf wird aber markiert, bevor er ausgeführt wird. Der Detektor muss den versteckten Text dafür gar nicht finden, er bewertet die Aktion. Deshalb ergänzt er die Erkennung von Prompt-Angriffen, statt sie zu ersetzen. Diese prüft, was der Agent liest, und soll eine solche Anweisung stoppen, bevor das Modell ihr folgt. Die Erkennung gefährlicher Abweichungen prüft, was der Agent tun will. Sind beide aktiv, muss ein Angriff zwei unabhängige Prüfungen überwinden. Und eine Abweichung ohne Angreifer trifft trotzdem auf die zweite.
Was passiert bei einer Markierung?
Ein markierter Aufruf geht mit einer Erklärung in drei Fassungen an die Anwendung zurück: einer Begründung für den Nutzer des Agenten, einer Anleitung, nach der der Agent selbst handeln kann, und Hinweisen für die Entwickler. Wie es weitergeht, entscheidet die Anwendung. Im einfachsten Fall gilt eine Markierung als Stopp. Bei kritischen Vorgängen ist es besser, die Aktion anzuhalten und von einem Menschen freigeben zu lassen. Lehnt er ab, endet die Sitzung, oder der Agent folgt der Anleitung und sucht einen anderen Weg. So entscheidet ein Mensch nur bei den Schritten, auf die es ankommt, und der Agent behält bei allem anderen seine Autonomie.
Zwei Punkte gehören zur Architektur. Die Prüfung läuft in der Infrastruktur von Check Point; die Tool-Aufrufe gehen dabei an keinen weiteren KI-Anbieter. Und die Durchsetzung einer Markierung sollte nicht allein im Code des Agenten liegen: wer dessen Laufzeitumgebung kompromittiert, kann eine Prüfung dort einfach überspringen. Die Durchsetzung gehört deshalb an eine Stelle, die der Agent selbst nicht erreicht.
Fazit
KI-Agenten werden weiter von ihren Aufgaben abweichen. Die meisten Abweichungen sind harmlos, und manche führen zu Lösungen, an die niemand gedacht hat. Es geht darum, die wenigen gefährlichen Abweichungen abzufangen, bevor sie ausgeführt werden, und den Rest in Ruhe zu lassen.
#CheckPoint